常规线段树
本质是划分成多段,然后逐步合并,是一棵二叉树
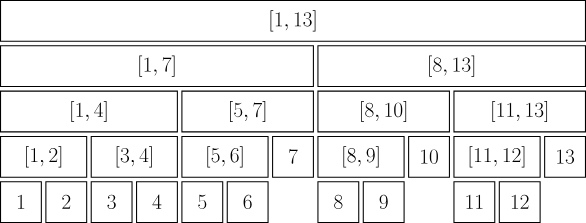
这张图清晰的展示了线段树的区间包含的范围
单点更新的逻辑就是,根据你要找的位置,转移到左边一半或者右边一半
查询的逻辑是合成大西瓜,
每次看分界线左右是否有自己需要的内容,若有,就过去获取,
要是发现当前访问到的区间全部在自己的所需范围之内了,那么全部获取,不继续向下遍历
考虑到可能你不会常规线段树,也就是只有区间查询的,所以下面放个板子
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| const ll N=2e5+10;
ll tr[4*N];
void build(ll l,ll r,ll now){
if(l==r){
tr[now]=a[l]%mod;
return;
}
ll mid=(l+r)>>1;
build(l,mid,now<<1);
build(mid+1,r,now<<1|1);
tr[now]=max(tr[now*2],tr[now*2+1]);
}
void update(ll l,ll r,ll now,ll pos,ll val){
if(l==r){
tr[now]=max(tr[now],val);
return;
}
ll mid=(l+r)>>1;
if(pos<=mid) update(l,mid,now*2,pos,val);
if(pos>mid) update(mid+1,r,now*2+1,pos,val);
tr[now]=max(tr[now*2],tr[now*2+1]);
}
ll query(ll ql,ll qr,ll l,ll r,ll now){
if(ql<=l&&r<=qr) return tr[now];
ll mid=(l+r)>>1,maxn=0;
if(ql<=mid) maxn=max(maxn,query(ql,qr,l,mid,now*2));
if(qr>mid) maxn=max(maxn,query(ql,qr,mid+1,r,now*2+1));
return maxn;
}
|
带懒标记的线段树
什么是懒标记
我的理解是:懒标记表示当前节点已经应用,但子节点还没应用的变换
这个信息告诉我们,下面的每个节点该怎么修改
因为我们显然不可能每次修改全部的节点,所以需要一个标记
找到被当前需要修改的区间覆盖的最靠上的区间,就是我们打标记的位置,
因为再下面的也会被这个区间包含,而我们暂时用不到,不如先不改,等那次用到了再改
push_down
因为查询和更新都会用到push_down这个概念,所以为了代码的简洁性,在我的板子中会被封装成一个函数
为什么会需要这个呢? 因为当需要查询或者修改一个已经被修改过的大区间下面的小区间时,这个区间其我们还没有对其进行实际修改,但是我们可以通过大区间指明的修改方向,修改我们的区间
比如区间加,大区间的标记告诉我们下面的节点要加上X,
那么现在传递,下面直接连着的小区间增加对应的值,并打上标记,表示再下一层的区间也要加上x
大区间的标记变为0,也就是下面不需要再加了
1
2
3
4
| --------------------大区间----------------------
tr[now] tag[now]
--------小区间1--------|--------小区间2----------
tr[now*2] tag[now*2] tr[now*2+1] tag[now*2+1]
|
所以这个函数的逻辑就是:
1
2
3
| 计算下面的区间新值
更新下面的区间的新标记
清除当前节点的标记
|
单个懒标记
这一类题目就是只有一种区间修改,很好理解,最简单的例子就是区间加,求区间和
那么push_down按照上面的逻辑,写出来就是:
1
2
3
4
5
6
7
8
9
| void push_down(ll l,ll r,ll now){
ll m=(l+r)>>1;
ll lsz=m-l+1,rsz=r-m;
tr[now*2]+=tag[now]*lsz;
tr[now*2+1]+=tag[now]*rsz;
tag[now*2]+=tag[now];
tag[now*2+1]+=tag[now];
tag[now]=0;
}
|
其他的比如乘,异或之类的全是这个逻辑
多个懒标记
最经典的题目就是加和乘混合,求区间和(P3373)
这里需要考虑一个懒标记表示的含义的问题
上面加的含义是,下面的小区间全部要加x
那么因为我们既要区间加又要区间乘,那么我们就要明确懒标记的含义
比如我们现在有两个懒标记,一个是乘的mul,一个是加的add
考虑不同的计算顺序,有两种:
先加再乘和先乘再加
先乘再加
先来看先乘再加
按照懒标记的定义,下面每个点都必须乘mul再加add
首先考虑对区间值的影响,显然是直接先mul再add,这没啥好说的
那么对下面节点标记的影响呢?
本来再下一层的计算是:
现在乘加:
所以乘还是乘,但是加却变多了,需要先乘再加
于是push_down:
1
2
3
4
5
6
7
8
9
10
11
12
13
| void push_down(ll l,ll r,ll now){
if(add[now]==0&&mul[now]==1) return;
ll mid=(l+r)>>1;
ll lsz=mid-l+1,rsz=r-mid;
tr[now<<1]=(tr[now<<1]*mul[now]%mod+lsz*add[now]%mod)%mod;
tr[now<<1|1]=(tr[now<<1|1]*mul[now]%mod+rsz*add[now]%mod)%mod;
add[now<<1]=(add[now<<1]*mul[now]%mod+add[now])%mod;
add[now<<1|1]=(add[now<<1|1]*mul[now]%mod+add[now])%mod;
mul[now<<1]=mul[now<<1]*mul[now]%mod;
mul[now<<1|1]=mul[now<<1|1]*mul[now]%mod;
add[now]=0;
mul[now]=1;
}
|
这里有一个易错点:
mul得设成1,不然下次乘就失效了,所以开头build的时候,也得先初始化为1
先加再乘
直接推导式子,注意形式要凑成一致
使用到了除法,,那么要是题目给的余数不是质数,那不是就没法做了
理论没问题,但是复杂了,不如前面的
这也是为什么这道题目采用先加再乘的原因
多个懒标记无非就是自己凑一下式子,然后计算变化就行
区间修改
注意区间修改的写法,再次强调懒标记的定义是下面的区间怎么操作,自己得先算完
所以算到需要的那个位置时,要更新自己的值,并更新懒标记,也就是指明下面该怎么做
比如乘法的修改:
1
2
3
4
5
6
7
8
9
10
11
12
13
| void update_mul(ll ul,ll ur,ll l,ll r,ll now,ll v){
if(ul<=l&&r<=ur){
mul[now]=mul[now]*v%mod;
add[now]=add[now]*v%mod;
tr[now]=tr[now]*v%mod;
return;
}
push_down(l,r,now);
ll mid=(l+r)>>1;
if(ul<=mid) update_mul(ul,ur,l,mid,now<<1,v);
if(ur>mid) update_mul(ul,ur,mid+1,r,now<<1|1,v);
tr[now]=(tr[now<<1]+tr[now<<1|1])%mod;
}
|
这里不仅需要修改mul,还要修改add.
其次,注意一下使用的函数,别写错函数!!!最好不要复制,很容易出错,容易一步错,步步错
push_down的使用时机
查询和修改时,要是需要访问一个区间下的小区间时,就必须得下放一下,不然下面的小区间使用的将会是错误的值
所以说修改和查询的逻辑应该是:
1
2
3
4
5
6
7
8
| void work(ql,qr,l,r,now){
if(ql<=l&&r<=qr){
计算当前区间
return;
}
push_down();
计算左右
}
|
多维护值的线段树
首先为什么一颗线段树会要多个维护值,显然是因为只靠一个值算不出答案
线段树维护二进制串中连续1的最大长度
举个例子:用线段树维护二进制串中连续1的最大长度(P2572的子问题)
看似不难对吗
但是注意到,这些1的段可以跨区间存在
1
2
3
4
5
6
7
8
| --------------------大区间----------------------
--------小区间1--------|--------小区间2----------
111111110000000000000000000000000000000000000000 case1
001111110000000000000000000000000000000000000000 case2
000000000000000000001111111000000000000000000000 case3
111111111111111111111111111111111100000000000000 case4
000000000000000000000000000000000111111111111110 case5
000000000000000000000000000000000111111111111111 case6
|
也就是说区间需要一种更nb的合并方式
维护区间信息
为此,我们需要维护3个量:头上的最大连续h1,尾上的最大连续t1,以及区间中的最大连续l1
这三个量满足的关系如下:
1
2
3
4
5
6
7
8
| void update(ll l,ll r,ll now){
ll mid=(l+r)>>1,lsz=mid-l+1,rsz=r-mid;
l1[now]=max({l1[now<<1],l1[now<<1|1],t1[now<<1]+h1[now<<1|1]});
h1[now]=h1[now<<1];
t1[now]=t1[now<<1|1];
if(l1[now<<1]==lsz) h1[now]=lsz+h1[now<<1|1];
if(l1[now<<1|1]==rsz) t1[now]=rsz+t1[now<<1];
}
|
连续段的最大值,要么是左边最大,要么是右边最大,要么是头尾合并的更大的
头尾最大也要考虑一下,逻辑是要是允许跨分界线,那么能得到更大的值
查询
必须要返回结构体的原因是,虽然我们已经算出了某些区间的最长段,但是却不能保证刚好合成查询区间
错误示例1:
1
2
3
4
5
6
7
8
|
ll query_ll(ll ql,ll qr,ll l,ll r,ll now){
if(ql<=l&&r<=qr) return l1[now];
ll mid=(l+r)>>1,ans=0;
if(ql<=mid) ans=max(ans,query(ql,qr,l,mid,now<<1));
if(qr>mid) ans=max(ans,query(ql,qr,mid+1,r,now<<1|1));
return ans;
}
|
如果直接选择最大的,那么缺少了一些跨区间的,像这样,仅仅是取到了查询区间中的几个小区间的最大值,合并可能产生更大区间
那么我直接加上不就好了?
错误示例2:
1
2
3
4
5
6
7
8
9
|
ll query_ll(ll ql,ll qr,ll l,ll r,ll now){
if(ql<=l&&r<=qr) return l1[now];
ll mid=(l+r)>>1,ans=0;
if(ql<=mid) ans=max(ans,query(ql,qr,l,mid,now<<1));
if(qr>mid) ans=max(ans,query(ql,qr,mid+1,r,now<<1|1));
if(ql<=mid&&mid<qr) ans=max(ans,t1[now<<1],h1[now<<1|1]);
return ans;
}
|
还是错的啊,因为注意这个错误的更新条件
我们向下查询时,只是发现下面有我们需要的信息才往下,没说全部都是所需信息
按这个逻辑,合并时可能会得到并不在查询区间内的数据,所以还是错误的
正确逻辑:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
|
struct node{ll len,pre,suf,maxn;};
node query_l1(ll ql,ll qr,ll l,ll r,ll now){
if(ql<=l&&r<=qr) return{r-l+1,h1[now],t1[now],l1[now]};
ll mid=(l+r)>>1;
node A,B;
ll pre,suf,len,maxn;
if(ql<=mid) A=query_l1(ql,qr,l,mid,now<<1);
if(qr>mid) B=query_l1(ql,qr,mid+1,r,now<<1|1);
if(qr<=mid) return A;
if(ql>mid) return B;
pre=A.pre==A.len?A.len+B.pre:A.pre;
suf=B.suf==B.len?B.len+A.suf:B.suf;
maxn=max({A.maxn,B.maxn,A.suf+B.pre});
len=min(qr,r)-max(ql,l)+1;
return{len,pre,suf,maxn};
}
|
通过结构体,保证了合并时得到的都是需要的信息,并且能正确的合并两个区间
